ao3 的作品库按标签组织,而不是按热度排。原作、角色、配对、附加标签与预警这几个层面叠在一起,构成一篇作品的完整索引。检索时搭对了,几页就翻到底;搭错了,翻十几页也碰不到想看的类型。
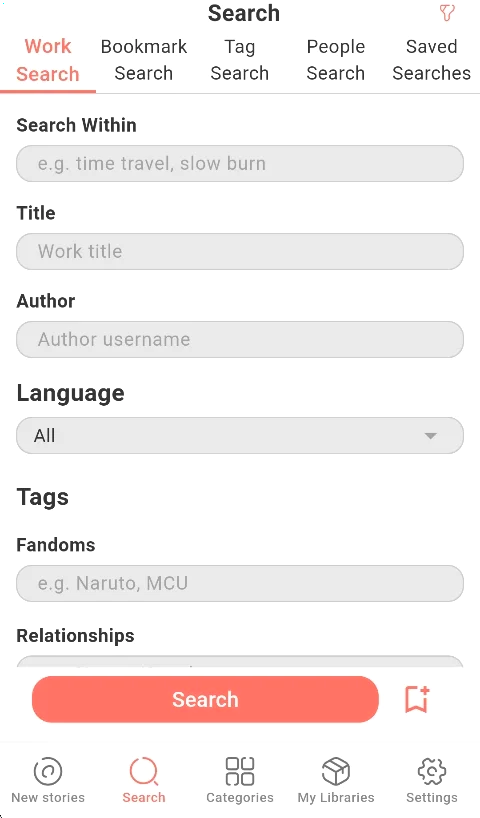
标签不是一堆平铺的关键词,而是分层级的。每一层回答一个不同的问题,检索时分层填写,比把所有词塞进同一个搜索框要准确得多。
| 层面 | 回答的问题 | 写法示例 |
|---|---|---|
| 原作 | 故事基于哪一部作品 | 某部动画、某本小说、某个游戏的名字 |
| 角色 | 出场的是哪些人物 | 人物本名,通常与配对的写法一致 |
| 配对 | 人物之间的关系走向 | 两个名字用斜杠连接表示恋爱向,用 & 连接表示友情向 |
| 附加标签 | 具体题材与设定 | 时间循环、职场、校园、失忆、平行世界之类的自由标签 |
| 预警 | 需要提前知道的内容提示 | 创作者在发布时勾选或自行填写的注意事项 |
斜杠与 & 的区别是这套体系里最容易被忽略的一条。同一个配对,两种写法指向的是完全不同的作品集合,检索时不要混用。想两边都看,就把两种写法分别检索一遍。
附加标签是自由填写的那一层,因此同一个意思可能有多种表达。这不是缺陷,而是这套体系的设计取舍:宁可有近义写法,也不强制统一,以免创作者为了迁就分类而放弃表达。
同一层内部是「或」,不同层之间是「与」。理解这一条,基本就能预测结果会怎么变化:在同一层多写几个词,结果会变多;在不同层各写一个词,结果会变少。
所以有效的做法是「一层放宽、另一层收紧」。原作层只留一个确切的名字,附加标签层多写几个近义写法,这样既不会漏掉变体写法,也不会把范围扩到别的原作上。
结果条数为零是最常见的卡点,处理方式不是继续改词,而是先把条件砍到一个。确认单一条件本身有结果,再一个层面一个层面地加回去,加到哪里归零就是哪一层设得太窄。
筛选面板里有独立的排除栏。想把某一类内容长期挡在结果之外,正确的动作是写进排除栏,而不是每次在结果列表里手动跳过。
排除栏对附加标签与预警尤其有用。比如不想看悲剧向结局,或不想碰某个特定设定,填一次之后,后续每次检索都自动过滤,等于给账号挂了一条长期规则。
需要注意排除项不会影响收藏与书架——已经在书架里的作品不会被清掉,排除只作用于检索结果。这条边界分清楚,就不会担心「设置完把以前的书弄丢了」。
结果默认按相关度排,也可以切成按更新日期、字数、互动数量等维度。找新文看更新日期,找长篇看字数,找已经过验证的老文看互动数量,三种排序对应三种完全不同的目的。
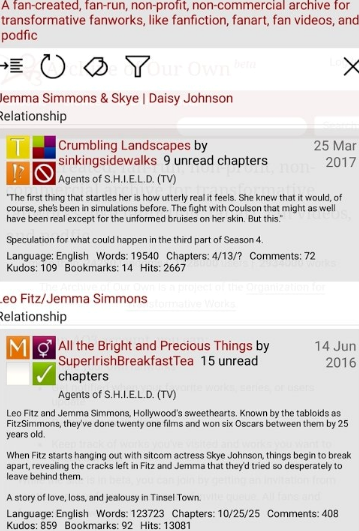
每条结果都带着一组信息:标签、字数、章节数、语言与完成状态。判断要不要点开,通常看标题下方那一行标签就够了,不必逐个进详情页。标签里出现预警字样时,先想清楚自己能不能接受再打开。
如果某一套筛选条件反复用,可以把它存成一条检索记录。存下来之后,打开客户端直接点一下就回到那批结果,不必每次重新填一遍。
值得存的通常是三类:常看原作的全部新文、某个配对的全部作品、以及带固定排除项的通用筛选。前两类偏「范围」,第三类偏「规则」,三类可以并存。
存下来的检索不会自动更新内容,它存的是一套条件而不是一份清单。作者发新章、作品被补标签,结果都会跟着变,这也是它比手工整理书单更省心的原因。
条件填好、结果收窄,剩下的事交给阅读界面就够了。